智能车新生培训
从一辆小车出发:Linux · 编程 · 数据结构与算法
讲义和这份 PPT 课后发给大家? 查看翻页快捷键
自我介绍,一句话说明今天要干什么:把一条完整的路线走一遍。
需要的话打开讲者窗口(W)。
今天的路线:一辆小车
① 准备车库
~/linux-lab Linux :终端、文件、管道
② 在直线上走
p = 2 C++ :从编译运行到类、CMake
③ 在网格上自己找路
数据结构与算法 :数组 … BFS、Dijkstra、A*
每一部分都在给小车加一点本事。后面的内容建立在前面的基础上。
强调主线:同一辆小车,从直线走到网格,最后自己找最短路。
大一同学:C++ 从第一个程序讲起,和 C 课互相对照;大二同学:注意 C++ 和 C 的差别。
目录
写在前面
第一站 Linux 的基础使用
终端与 Shell,文件系统与路径 操作文件,常用命令 重定向与管道 第二站 C++ 编程基础
编译运行,变量、条件、循环、函数 类与对象,继承与多态 多文件、库与 CMake
第三站 数据结构与算法
存下来 :数组、vector、二维数组算得快 :复杂度,排序与二分,前缀和建模 :图,网格就是图探索 :栈与 DFS,队列与 BFS,树最短路 :递推,Dijkstra,A*,算法赛跑回头看 :标准库容器
回顾:小车走过的路
讲义里的标记:试一下、想一想、本节要点;标题带“选读”的第一遍可以跳过。
课上建立整体印象,细节在讲义里;课后每段代码亲手敲、亲手运行。 考核范围现在就说,大家心里有底。
学会提问,用好 AI
一个好问题包含
把问题写清楚的过程,常常就把问题解决了。向人提问、向 AI 提问是同一项能力。
AI 可以帮你
解释刚接触的概念,用更基础的例子说明 检查你对报错、对知识的理解有没有漏洞 整理笔记和复盘
简单带过,后面讲 undefined reference 时会回到“怎样提问”。
第 一 站
准备车库:Linux 的基础使用
先学会在文件系统里“移动自己”
你敲下一条命令时,发生了什么
你
→
终端文字输入输出的窗口
→
ShellBash:解释命令
→
程序ls、g++ …
→
内核管理 CPU、内存、设备
发行版 (Ubuntu、Debian)= 内核 + 系统工具 + 软件管理,组织成一个能用的系统。
培训推荐 WSL 或虚拟机上的 Ubuntu 22.04 ,课前装好 build-essential cmake libfmt-dev。
不需要记定义,知道“终端只是窗口,命令由 Shell 解释”即可。 问一下谁还没装好环境,课后找学长。
文件系统是一棵倒过来的树
/
home
tmp
student
linux-lab
hello.txt
notes/
← 你在这里(pwd)
= ~ 主目录
当前工作目录 :“我现在在哪”。cd 移动,pwd 报告位置。
绝对路径 从 / 出发/home/student/linux-lab/hello.txt 相对路径 从当前目录出发hello.txt ./hello.txt ../
. 当前目录 .. 上一级 ~ 主目录
讲到 BFS 时,我们还会见到“树”。
小车在直线、网格上移动;这里先移动的是“你自己”。 现场演示:pwd、cd /tmp、pwd、cd ~。 埋伏笔:树,parent,cd .. 就是走向 parent。
建好车库,操作文件
$ cd ~
$ mkdir linux-lab  # 创建目录
$ cd linux-lab
$ mkdir notes
$ touch hello.txt  # 创建空文件
$ ls
hello.txt  notes
$ nano hello.txt  # Ctrl+O 保存,Ctrl+X 退出
$ cp hello.txt hello-copy.txt  # 复制
$ mv hello-copy.txt notes/  # 移动(或重命名)
$ rm notes/hello-copy.txt  # 删除
注意 rm 删除的文件不进回收站 。-r:cp -r、rm -r,执行前确认路径。
VS Code 在目录里执行 code .. 就是“当前目录”。
Linux 区分大小写:hello.txt ≠ Hello.txt
命令速查 不用背,用多了就记住了
命令 用途 来自 pwd显示当前目录 print working directory ls列出内容 list cd切换目录 change directory mkdir创建目录 make directory cp / mv / rm复制 / 移动 / 删除 copy / move / remove cat显示文件内容 concatenate sudo以管理员权限执行 superuser do
让终端更好用
Tab 补全,按两次列出所有可能↑ ↓ 翻历史命令Ctrl+C 中止程序(后面写出死循环时用得上)Ctrl+Shift+C / V 复制粘贴ls --help、man ls 查看用法
sudo 弄清含义之前,不要随手复制执行带 sudo 的命令。
重定向:让输入输出换个方向
键盘 / 文件标准输入
→
程序不用做任何修改
→
终端 / 文件标准输出、标准错误
$ ls > list.txt          # 屏幕上什么也没有
$ echo "第二行" >> list.txt
$ printf '5\n12\n3\n8\n' > nums.txt
$ sort < nums.txt
12
3
5
8
$ sort -n < nums.txt > sorted.txt
$ ls nothing 2> err.txt
>输出写入文件,覆盖 原内容 >>输出追加到文件末尾 <从文件读取输入 2>报错(标准错误)写入文件
不加 -n:按文字排,"12" 在 "3" 前面-n:按数值排,3、5、8、12
注意 > 会先清空目标文件,写错文件名就找不回来了。
list.txt 里会出现 list.txt 自己:Shell 先创建文件,再运行 ls。 编译报错很长时,g++ … 2> err.txt 存下来附在提问里。
管道:把命令串起来
ls
→ | →
grep txt只留含 txt 的行
→ | →
wc -l数有几行
$ ls | wc -l                  # 有几项
$ sort -n nums.txt | head -n 2
3
5
$ cat nums.txt | grep 1
12
$ ls | grep txt | wc -l
前一个命令的输出 ,直接作为后一个命令的输入 ,不需要中间文件。
每个命令只做好一件小事,用管道组合起来完成复杂任务。
别混淆 Shell 的 >> 是追加、<< 是 here document;cout <<、cin >> 没有关系 。
写完 C++ 程序后,用同样的方法给它喂数据、查输出 。
第 二 站
让小车在直线上走
直接写 C++:边写边认识变量、条件、循环、函数、类
第一个程序 ~/linux-lab/hello.cpp
⟦#include <iostream>⟧

⟦int main()⟧ {
    std::cout << "小车准备出发\n";
    return 0;
}
#include <iostream>:引入输入输出功能int main():程序从这里开始执行 std::cout << …:输出到终端,\n 换行return 0;:正常结束每条语句以 ; 结尾
std:: 表示来自标准库。别处的 using namespace std; 可以省掉它,讲义保留,看得清来源。
目标:输入目标位置,小车一格一格走过去,每格报告一次。 这一站结束时写出来。
不要求记住每行语法,先跑起来;大一同学会发现和 C 课的 printf 版本结构一样。
编译、运行、读报错
$ g++ -std=c++17 hello.cpp -o hello
$ ls
hello  hello.cpp
$ ./hello
小车准备出发
g++C++ 编译器 -std=c++17使用 C++17 标准 -o hello输出文件叫 hello ./hello运行当前目录下的 hello
试一下 改掉输出文字,保存后直接 运行 ./hello,变了吗?再编译一次,再运行。
改了源代码,要重新编译。 hello.cpp 是源代码,hello 是可执行文件。
删掉一个分号再编译:
hello.cpp:4:34: error: expected ‘;’ before ‘return’
文件:行:列 + 原因。先看第一条 error。
代码怎样变成能运行的程序
hello.cpp源代码
→
预处理处理 #include
→
编译翻译成机器指令
→
链接把各部分和库连起来
→
hello可执行文件
一条 g++ 命令就完成了这些步骤。“编译”和“链接”在多文件项目里会分别出场。
编译型(C++) 先整体翻译成机器指令,再运行。计算密集的任务通常更快,智能车的控制程序常用 C/C++。
解释型(Python) 由解释器读取代码并执行。改完就能跑,写起来方便。
变量:记住小车在哪
int main() {
    ⟦int p = 0;⟧    // 位置,初值 0
    p = p + 1;     // 前进一格
    p = p + 1;
    p = p + 1;
    std::cout << "位置:" << p << '\n';
}
int 是类型 :p 保存整数。 简写:p += 1; ++p;
= 不是“相等”,是赋值 :
p ← p + 1
0 1 2 3
p 依次变成 1、2、3:变量记住了小车的位置
数学里 p = p + 1 不成立,这里读作“更新”。这是新手最常卡住的点。 幻灯片上省略了 #include,讲义里是完整程序。
几种常用类型
int p = 3;                 // 整数
double speed = 0.5;        // 小数
bool arrived = false;      // 真 / 假
char mark = 'S';           // 单个字符
std::string name = "小车"; // 字符串
const int END = 10;        // 常量,不能再改
std::string 需要 #include <string>
类型 规定一个值能怎样用:3 能做加法,"3" 只是一段文字。
注意 7 / 2 得 3 ,7.0 / 2 才得 3.57 % 2 取余数,得 1
函数里单写 int p; 不保证是 0,使用前先赋值 。
输入与条件判断:不能越过终点
const int END = 10;
int p = 8;
int steps = 0;
⟦std::cin >> steps;⟧          // 运行时再给格数

if (⟦p + steps <= END⟧) {
    p += steps;
    std::cout << "位置:" << p << '\n';
} else {
    std::cout << "这次移动会超过终点\n";
}
输入 2 → 走到 10
>> 读进来,<< 写出去:箭头指向数据流动的方向。
< > <= >= == != 比较&& 并且 || 或者 ! 取反
区分 p = 10 赋值p == 10 判断是否相等
while:条件成立就继续
int p = 0;
int target = 0;
std::cin >> target;

while (⟦p < target⟧) {
    ⟦p += 1;⟧
    std::cout << p << '\n';
}
std::cout << "到达目标\n";
每轮开始前检查条件:真就再执行一遍,假就结束。
输入 3:输出 1、2、3、到达目标
想一想 漏写 p += 1; 会怎样?Ctrl+C 。重复什么 ,以及怎样结束 。
这句“循环要能结束”后面 BFS 的“已发现标记”会回扣。
for:重复固定次数
for (⟦int i = 0⟧; ⟦i < 3⟧; ⟦++i⟧) {
    p += 1;
    std::cout << p << '\n';
}
① 初始化只做一次
→
② 检查条件每轮开始前
→
循环体
→
③ 更新每轮结束后
↺ ②
i 取 0、1、2,循环体执行 3 次,输出 1、2、3。i 是计数器,p 是位置,角色不同。
函数:给一段操作起名字
⟦int⟧ remaining(⟦int position, int target⟧) {
    ⟦return⟧ target - position;
}

int main() {
    int d = remaining(5, 10);   // d = 5
    std::cout << "还差 " << d << " 格\n";
}
函数名前:返回值类型 ;括号里:参数 和类型
定义时不执行,调用 时才执行
return 把结果交回调用处 ;cout 只是给人看不交回结果,返回值类型写 void
入门时,函数定义写在 main 前面
想写个 move,却改不了外面的 p
void move(int p, int steps) {
    p += steps;
}

int main() {
    int p = 0;
    move(p, 3);
    std::cout << p << '\n';   // 输出 0
}
按值传递 :交给函数的只是 p 的值 。函数里的 p 是另一个变量,改它不影响 main 里的 p。
作用域 :花括号里定义的变量,只在这对花括号里有效。
车一多,p1、p2、p3 满天飞……能不能让每辆车自己记住位置,自己会移动?
学过 C 的同学会想到传指针;C++ 还有引用。这里不展开,引出类。
类与对象:每辆车记住自己的位置
class Car {
⟦public:⟧
    int position = 0;
    void move(int steps) {
        position += steps;
    }
    void report() {
        std::cout << position << '\n';
    }
⟦};⟧
Car carA;
Car carB;
carA.move(3);
carB.move(5);
carA.report();   // 3
carB.report();   // 5
类 Car:共同的规则
carA:position 3
carB:position 5
成员变量 position、成员函数 move/report · public: 让外面能用 · 结尾是 };
类 描述共同的结构和行为,对象 保存某一个实例自己的状态。
成员函数里直接写 position,指的就是这次被调用的那辆车。 别处见到的 new Car() 会返回指针,入门先不用。
放到一起:完整的小车程序 ~/linux-lab/car.cpp
#include <iostream>

class Car {
public:
    int position = 0;
    void move(int steps) { position += steps; }
    void report() { std::cout << position << '\n'; }
};

int main() {
    Car car;
    int target = 0;
    std::cin >> target;
    while (car.position < target) {
        car.move(1);
        car.report();
    }
    std::cout << "到达目标\n";
    return 0;
}
$ g++ -std=c++17 car.cpp -o car
$ ./car
3
1
2
3
到达目标
变量、条件、循环、函数、类:换一门语言写法不同,概念相通。
还差一个问题:怎样一次保存很多个值? 第三站揭晓。
不用每次手敲:重定向 + diff
$ echo 3 > in.txt
$ ./car < in.txt > out.txt
$ printf '1\n2\n3\n到达目标\n' > ans.txt
$ diff out.txt ans.txt
$ echo $?
0
$ diff out.txt ans2.txt     # ans2 第 3 行写成了 4
3c3
< 3
---
> 4
std::cin 读标准输入,std::cout 写标准输出:程序不用改 。也可以 echo 3 | ./car。
diff 没有输出 = 完全相同。$? 是上一条命令的退出码 ,0 表示成功;return 0; 交出的就是它。
看不见的差别 行末空格、末尾换行、Windows 的 \r\n 都算不同。diff -b、diff --strip-trailing-cr
准备输入 → 运行 → 和期望输出比较 :这就是测试。考核题的评测工具做的也是这件事。
继承:快车也是一种车
class Car {
public:
    int position = 0;
    ⟦virtual⟧ void step() { position += 1; }
    ⟦virtual⟧ std::string name() { return "普通车"; }
    void report() {
        std::cout << name() << " 在 " << position << '\n';
    }
};

class FastCar ⟦: public Car⟧ {
public:
    void step() ⟦override⟧ { position += 2; }
    std::string name() ⟦override⟧ { return "快车"; }
};
: public Car:FastCar 继承 Car,自动拥有 position、report,只写不同的部分Car 是基类 ,FastCar 是派生类
virtual:允许派生类改写这个函数override:让编译器检查“确实改写了基类的 virtual 函数”,名字拼错会报错
多态:同一句 car.step(),不同的车不同的走法
void drive(⟦Car& car⟧, int target) {
    while (car.position < target) {
        car.step();
        car.report();
    }
}

Car a;
FastCar b;
drive(a, 3);
drive(b, 3);
普通车 在 1
普通车 在 2
普通车 在 3
快车 在 2
快车 在 4
Car& 是引用 :不是副本,就是调用处那辆车本身。int& p 就能改了。
想一想 删掉 virtual 和 override,快车会输出什么?
实际项目:多种传感器、多种控制策略,主程序只调用同一个接口,换一种也不用改主程序。
按值传递 Car car 会把快车复制成普通 Car,“快”的部分丢掉。 vector<unique_ptr<Car>> 和虚析构留给以后。
学过 C 的同学,留意这几处
内容 C 语言 本讲义的 C++ 输入输出 <stdio.h> scanf("%d", &x)<iostream> std::cin >> x 不写 & 真假 要 <stdbool.h> bool、true、false 直接用字符串 char 数组std::string,能 + 拼接、== 比较数组长度 #define N 10const int N = 10;结构体变量 struct Car car;Car car;改调用处的变量 传指针 &p 指针,或者引用 ;本讲义用类来组织
此外还会用到 C 没有的类和标准库容器(vector、stack、queue 等)。
把小车拆成三个文件 ~/linux-lab/car-project
car.h 声明
#pragma once

class Car {
public:
    int position = 0;
    void move(int steps);
    void report();
};
“有这个函数,怎么调用”
car.cpp 实现
#include "car.h"
#include <iostream>

void Car::move(int steps) {
    position += steps;
}
void Car::report() {
    std::cout << position << '\n';
}
“这个函数具体做什么”
main.cpp 使用
#include "car.h"
#include <iostream>

int main() {
    Car car;
    // …和之前一样
}
安排程序的执行过程
为什么拆?测试程序也要用 Car 时,共用一份 代码,改移动规则只改一处。
#pragma once 防止重复包含,主流编译器都支持;标准写法是 #ifndef CAR_H 头文件保护。
包含了头文件,为什么还报错?
$ g++ -std=c++17 main.cpp -o car
⟦undefined reference to `Car::move(int)'⟧
⟦undefined reference to `Car::report()'⟧
undefined reference:用到了某个函数,却没找到它的定义。
想一想:卡在这里,你会怎样提问? g++ -std=c++17 main.cpp -o car 时,出现 undefined reference to 'Car::move(int)'。main.cpp 已经包含了 car.h,car.cpp 里也写了 move 的定义。”
写到“命令里只有 main.cpp”,问题就找到了 → g++ -std=c++17 main.cpp car.cpp -o car
回扣开场“学会提问”:背景、现象、尝试。 停一下,让大家先猜问题出在哪。
编译与链接是两个环节
main.cpp car.cpp main.o car.o car 编译 -c 编译 -c
链接
目标文件,还不能直接运行
move 的调用在这里接上实现
$ g++ -std=c++17 -c main.cpp -o main.o
$ g++ -std=c++17 -c car.cpp -o car.o
$ g++ main.o car.o -o car
包含头文件 ≠ 把对应的 .cpp 加入构建
使用别人写好的功能:库
#include "car.h"
#include <fmt/format.h>

void Car::report() {
    fmt::print("当前位置:{} 格\n", position);
}
$ g++ -std=c++17 main.cpp car.cpp -o car
⟦undefined reference to `fmt::v8::vprint(...)'⟧
$ g++ -std=c++17 main.cpp car.cpp -o car ⟦-lfmt⟧
用到的功能 接口:编译器要看到 实现:链接时提供 自己的 Car 包含 car.h 编译 car.cpp fmt 库 包含 fmt/format.h 链接 -lfmt
同样是 undefined reference,这次缺的是 fmt 的实现。
-I目录 头文件去哪找 -L目录 库去哪找 -l库名 用哪个库
把构建要求写下来:CMake
# CMakeLists.txt
cmake_minimum_required(VERSION 3.16)
project(CarDemo LANGUAGES CXX)

find_package(fmt REQUIRED)

add_executable(car main.cpp car.cpp)
target_compile_features(car PRIVATE cxx_std_17)
target_link_libraries(car PRIVATE fmt::fmt)
“要做出一个叫 car 的程序,由这两个文件构建,用 C++17,链接 fmt。”
$ cmake -S . -B build  # 读配置,生成构建文件
$ cmake --build build  # 真正编译、链接
$ ./build/car
再构建一次:
$ cmake --build build
[100%] Built target car
没有改动就不重新编译;改了 car.cpp,只重新编译它。
第二站小结
源代码要用 g++ 编译成可执行文件;读报错先看第一条 error。
变量有类型;if 选择,while/for 重复;函数按值传参;类把数据和操作打包。
继承沿用基类,virtual + 引用实现多态。
改了源代码,要重新构建 。
头文件提供接口;实现要靠编译 .cpp 或链接库。缺了实现 → undefined reference。
CMake:cmake -S . -B build 生成,cmake --build build 构建。
还没解决 车一多、路一长,要保存很多个值 :100 格路的耗电、一整张地图……
下一站,小车走出直线,走上一张地图。
第 三 站
走上网格,自己找路
存下来 → 算得快 → 建成图 → 探索 → 最短路
数据结构 = 组织数据的方式;算法 = 处理数据的步骤。 “程序 = 数据结构 + 算法”,学完回头再看,结尾回收。 路线:数组存地图 → 复杂度判断快慢 → 排序、前缀和先整理数据 → 地图抽象成图 → 栈 / 队列安排探索顺序 → 路况不同时求最小代价。
数组:一次保存很多个值 第二站留下的问题
一条路分成 5 格,每格耗电 3、1、4、1、5。写 5 个变量?100 格呢?
3 1 4 1 5
int cost[5] = {3, 1, 4, 1, 5};
int total = 0;
for (int i = 0; i < 5; ++i) {
    total += cost[i];   // 下标可以是变量
}
std::cout << total << '\n';   // 14
下标从 0 开始 :5 个元素是 0~4。
越界 cost[5] 已经出界。C++ 不检查,可能读到乱值,也可能崩溃,每次表现还不一样。
std::vector:会自己变长的数组
#include <vector>

std::vector<int> cost = {3, 1, 4, 1, 5};
cost.⟦push_back⟧(9);              // 末尾追加
std::cout << cost.⟦size()⟧;       // 6

int total = 0;
for (⟦int x : cost⟧) {           // 范围 for
    total += x;
}                                // total = 23

std::vector<int> road(100, 0);   // 100 个 0
尖括号里写元素类型:std::vector<std::string>
cost[i] 不检查越界;cost.at(i) 会检查,调试更好找错范围 for:依次取出每个元素,不用管下标
标准库里专门存放一组元素的类,叫容器
需要一组数据时,优先用 vector。
二维数组:一张网格地图
S 起点 T 终点 . 道路 # 障碍 ~ 泥地
位置从一个整数,变成 (行 r, 列 c) 。S = (2, 0),T = (2, 6)。
std::string grid[5] = {".......", ".####.#",
    "S.~~..T", ".#.##.#", "...#..."};
grid[2][0]   // 'S':第 2 行第 0 列
这张地图会反复出现。 先收起来:存得下了,还要算得快。到“图”再回来。
摄像头的一帧灰度图也是二维数组,每个元素是一个像素的亮度。
猜数字:1~100,最少问几次?
逐个猜 :1、2、3……最坏 100 次。
每次猜中间 :50 → 太小 → 75 → 太大 → 62……7 次。这就是二分查找 。
范围 逐个检查 二分查找 1~100 100 7 1~1,000 1,000 10 1~1,000,000 1,000,000 20
时间复杂度 数据规模 n 增大时,操作次数怎样增长 。
增长量级 忽略常数倍和低阶项:3n + 2 记作 O(n)
普通电脑每秒约 108 次简单操作,n = 105 时:
复杂度 大约用时 O(log n) 瞬间 O(n) 瞬间 O(n log n) 约百分之二秒 O(n²) 约一百秒
怎样看出一段代码是哪个量级? → 下一页
看代码估算复杂度 找出随 n 增长、执行最多的那部分
int x = cost[3];                     // O(1) 与 n 无关

for (int i = 0; i < n; ++i)          // O(n) 一层循环
    total += cost[i];

for (int i = 0; i < n; ++i)          // O(n²) 两两比较:
    for (int j = i + 1; j < n; ++j)  // 有没有两车用时相同?
        if (t[i] == t[j]) same = true;

for (int len = n; len > 1; len /= 2) // O(log n) 减半
    ++times;
嵌套相乘 :内层 n−1、n−2、…、0 次,共 n(n−1)/2 → O(n²)先后执行取最大 :O(n) 读入 + O(n²) 比较 → O(n²)看最坏情况 :猜数字运气好一次就中,但要保证“最多几次”空间复杂度 :内存随规模怎样增长。n 个数的数组 O(n)
二分能排除一半,是因为数据有序 。乱序的数据呢? → 先排序。
后面每个做法都估一下:冒泡 O(n²)、sort O(n log n)、前缀和查询 O(1)、BFS 与格子数成正比。 空间复杂度到“图”那里用上:邻接矩阵 n² vs 邻接表。
排序:5 辆车的用时 32、17、45、23、8
冒泡 :比较相邻两个,左边大就交换。一轮把最大的“浮”到最右(绿色已就位)。
约 n 轮 × 每轮 n 次 → O(n²)
for (int i = 0; i < n - 1; ++i)
    for (int j = 0; j < n - 1 - i; ++j)
        if (a[j] > a[j + 1])
            std::swap(a[j], a[j + 1]);
直接用 std::sort,然后二分查找
int t[5] = {32, 17, 45, 23, 8};
std::sort(t, t + 5);
// 8 17 23 32 45
t 到 t + 5:包含开头,不含结尾。O(n log n) 。
快速排序(选读):选基准、分两边、递归。递归一定要有终止条件。
int lo = 0, hi = n - 1;
while (lo <= hi) {
    int mid = lo + (hi - lo) / 2;
    if (a[mid] == x) return mid;
    if (a[mid] < x) lo = mid + 1;  // 太小了
    else hi = mid - 1;             // 太大了
}
return -1;
思路 花一次时间整理数据(O(n log n)),换来之后每次查找都快(O(log n))。
前缀和:提前算好,反复使用
调度员连问 q 次:“从第 l 格开到第 r 格,耗多少电?” 每次现加:O(nq),105 ×105 太慢。
s[i] :第 1 格到第 i 格的总耗电,s[0] = 0
s[i] = s[i-1] + cost[i]
l~r 的和 = s[r] − s[l-1]
第 2~4 格:9 − 3 = 6 预处理 O(n),每次查询 O(1)
这一节下标从 1 开始,让 l = 1 时 s[l-1] = s[0] 不用特判。
到这里处理的都是一排 数据。小车真正面对的是一张地图 → 图。
图:把地图抽象成点和边 哪里和哪里相通,路有多长
邻接矩阵 :mat[u][v] 存边权,没有边记 −1 (路长可能为 0,不能用 0 表示“没路”)。查边 O(1),但 n 个点要 n² 个位置。
邻接表 :每个点只记自己连着的边,std::vector<Edge> adj[N]。空间 O(点数 + 边数),点多边少时省得多。
点(顶点)、边、边权、邻居;无向图、有向图。 记住 A→B→D = 5,A→C→D = 7,Dijkstra 会用。
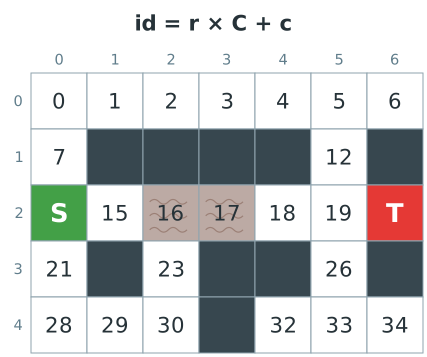
网格就是图 收起来的地图拿回来
id = r × C + c;r = id / C,c = id % C
每个能走的格子是一个点,相邻且都能走的两格之间有一条边。
int dr[4] = {-1, 1, 0, 0};  // 上 下 左 右
int dc[4] = {0, 0, -1, 1};
for (int k = 0; k < 4; ++k) {
    int nr = r + dr[k], nc = c + dc[k];
    ⟦if (nr < 0 || nr >= R || nc < 0 || nc >= C) continue;⟧
    if (grid[nr][nc] == '#') continue;
    // (nr, nc) 是一个能走的邻居
}
先判断出界,再访问 grid[nr][nc]。
地图存进程序了。接下来让小车从 S 出发,一格一格地探索。
终 点 站
让小车自己找路
能不能到?最少几步?最小代价?怎样找得更快?
探索地图的共同框架
把起点放进 todo,标记为“已发现”
while (todo 不为空) {
    从 todo 中⟦取出⟧一个格子 id
    for (id 的每个能走的邻居 next) {
        if (next 还没有被发现) {
            把 next 标记为“已发现”
            把 next 放进 todo
        }
    }
}
没有“已发现”标记 → 在两格之间来回走,停不下来 。还记得漏写 p = p + 1 吗?
唯一没说清的 从 todo 里取出哪一个?
最自然的两种:取最后 放进去的,或取最早 放进去的。各有一种专门的数据结构:栈 和队列 。
这一页是后面所有算法的骨架,后面“赛跑”会再回到这里。 先离开地图,用两个小例子认识栈和队列,再分别装进这个框架。
栈:后进先出 原路返回
小车走了 右 右 下 右。原路返回:最后做的,最先撤销 。
std::stack<char> history;
for (char m : std::string("RRDR")) history.push(m);
while (!history.empty()) {
    std::cout << opposite(history.top()) << ' ';
    history.pop();
}
// 输出 L U L L
一摞盘子、编辑器的“撤销”都是栈。
把栈当作 todo:每次取出最新发现 的格子 → DFS
讲义里用下标循环,这里为了省地方写成范围 for,口头说一句即可。
DFS:一条路走到底 todo 是栈
死胡同里,栈中剩下更早发现的格子 = 退回上一个岔路口 (和“原路返回”同理)。
按 S 单步讲两三拍,然后 P 播放。格子里的数字是取出顺序。 递归写法(选读):函数调用本身就是栈;地图太大会栈溢出。
DFS 能到,但不保证最短 终点就在正下方
T 在 S 正下方 4 格,DFS 却走了 14 步:“右”最后入栈、最先取出,它先往右钻到底。挑方向的顺序是写死的,没看终点在哪。
想一想 小车知道终点的坐标。如果每次优先探索离终点更近的格子 呢?换成岔路很多的迷宫,还一定最短吗?(留到 A* 回答)
按 E 直接看结果,再回头讲为什么先往右。 伏笔:这里不回答,A* 那页回来。 要最短,就不能急着往深处钻,先把近处处理完 → 引出队列。
队列:先进先出 排队充电
操作 std::stack std::queue 放入 push(x) 栈顶push(x) 队尾看下一个 top()front()移除 pop()pop()是否为空 empty()empty()
pop() 只移除、不返回值:先 top() / front() 取值,再 pop()。
把队列当作 todo:每次取出最早发现 的格子 → BFS :先把近处处理完,再往远处走
BFS:一圈一圈向外扩散 todo 是队列
按距离从近到远处理:一个格子第一次被发现时,步数就是最少步数 。dist 记步数,parent 记“从哪来”。
格子里的数字是步数。让大家看水波的形状。 复杂度:每格进出队一次,O(R×C),与格子数成正比。
同一张图,DFS 与 BFS 同时跑 每一拍,各取出一个格子
DFS 先往右钻(右是最后压栈、最先弹出的方向),绕了远路;BFS 一圈圈扩散,直接找到最短。 BFS 笔直向下 4 步。这里先预告“赛跑”,A* 之后还会再比一次。
沿着 parent 回到起点:树
除起点外,每格恰好一个 parent → 一棵树
起点是根 ;从任一格沿 parent 走,路线唯一
从 T 倒着走回 S,就得到最短路线(倒序)
最少需要 6 步
.......
.####.#
S*****T
.#.##.#
...#...
Linux 目录也是树:/ 是根,cd .. 就是沿 parent 走一步。
路况不同:驶入泥地代价 5
BFS 的 6 步路线穿过两块泥地:1+5+5+1+1+1 = 14 ;从上方绕 10 步,代价只有 10 。
BFS 只数步数。校园图也一样:A→B→D = 4+1 = 5,A→C→D = 2+5 = 7,都是两条边。
直接想有点难。先看一个简单情形:只能向右、向下走。
只能向右、向下:一格一格递推
每格代价含起点、终点,答案 8
f[r][c] = min(f[r-1][c], f[r][c-1]) + cost[r][c]
状态 :f[r][c] 表示什么转移 :怎样由之前的结果得到顺序 :先算谁,保证用到的已经算好
前缀和 s[i] = s[i-1] + cost[i] 也是递推:用算好的结果推出新结果 ,这就是动态规划 。
能随意走呢? X 依赖 Y,Y 又可能依赖 X,依赖绕成了圈 ,找不到事先定好的顺序。边算边定顺序 ,每次先确定代价最小的那一格。
只能向右、向下:(r, c) 的上一步只能来自上方或左方,从上到下、从左到右算,用到的一定已经算好。 依赖关系没有圈的有向图叫有向无环图,提一句即可。
Dijkstra:每次确定代价最小的那个
这一步确定 A B C D 开始 0 ∞ ∞ ∞ A(0) 0 4 2 ∞ C(2) 0 4 2 7 B(4) 0 4 2 7 → 5 D(5) 0 4 2 5
4 2 1 5 A B C D
为什么能直接确定? 别的路线要到 X,得先踏上某个未确定的点 Y,到 Y 已经不比 X 便宜,后面的代价又非负 ,不可能反超。
逐行按 →,每行让大家说出下一个确定谁。 负代价会让这个论证失效。 和上一页呼应:Dijkstra 也是“用算好的结果推新结果”,只是顺序按代价从小到大、边算边定。
Dijkstra 在网格上 todo 是小根堆:每次取出代价最小的
std::priority_queue<Item, std::vector<Item>, std::greater<Item>>:元素 (代价, 编号),取最小。代价全为 1 时,最短距离和 BFS 相同。
A*:把“终点在哪”用起来 回答 DFS 那页的问题
Dijkstra 只看已走代价 g:向四面八方均匀 扩展。
贪心 :只看离终点多远。简单地图上很快,钻进岔路就绕远。
A*:两头都算,按 f = g + h 取最小g 已走代价,h 剩余代价的估计
同样 16 步,Dijkstra 扩展 97 格,A* 只扩展 29 格。
先回到 DFS 绕远路那页:“优先走离终点近的”就是贪心,在那张图上 5 格就到;但它不管已经走了多远。 和猜数字呼应:能利用的信息越多,尝试越少。
h 怎样选? 真正的剩余代价正是要求的东西,只能估计
h 不必是某个固定公式,但要满足:
好算 :不能为了估计再搜一遍不高估 :h ≤ 真实剩余代价 → 仍保证最短每走一步,h 减少不超过这一步的代价 ,终点 h = 0格子取出后不再处理时需要;满足它,2 也成立
h(四方向网格,每步代价 ≥ 1) 效果 h = 0 没信息,就是 Dijkstra 直线距离 满足,信息少一些 曼哈顿 |r−rT | + |c−cT | 满足:每步行或列只变 1 曼哈顿 × 10 高估:扫得少,不保证最短,像贪心
满足条件的前提下,h 越接近真实剩余代价,扫得越少 。
高估为什么坏事:真正最短的路线被 h 压在后面,A* 先拿到一条较差的就结束了。 ROS 导航的全局规划里就有 Dijkstra 和 A*。
算法赛跑①:岔路迷宫 每一拍,各取出一个格子
先回到共同框架:五种算法只差“取出哪一个”。贪心 = 只看 h。
P 播放。先让大家猜谁先到,谁的路最短。
结论:DFS、贪心扫得少但绕远;BFS 最短但扫了大半张;A* 最短且只扫一半。 回收 DFS 那页的问题:只朝终点冲(贪心)会被岔路骗;A* 把 g 也算进来,才既快又最短。
算法赛跑②:泥地河 + 一座桥
BFS 直接蹚河,代价 32;Dijkstra、A* 绕到桥上,代价 28。
Dijkstra 扫得比 BFS 还多:它要把代价小于 28 的都确认一遍。不是更快,是更对。
从赛跑里看到的
算法 todo 每次取出 保证 DFS 栈 最后放进去的 能不能到 BFS 队列 最早放进去的 步数最少 Dijkstra 小根堆 g 最小 代价最小 A* 小根堆 g + h 最小 代价最小,扫得少 贪心 小根堆 h 最小 不保证最短
扫得少,不等于找得好。 路况一样用 BFS;路况不同用 Dijkstra / A*;只能向右、向下这类无环情形,直接递推。
同一个框架,换一种 todo 容器,就换了一种算法 。
想一想 把 A* 的 h 全部乘以 10,它更像 Dijkstra 还是贪心?
回头看:标准库容器 找路用过的,加上按名字查找
std::map<std::string, int> pos;  // 名字 → 位置
pos["小车一号"] = 3;
pos["小车二号"] = 5;
pos["小车一号"] += 2;            // 变成 5
pos.count("小车三号");           // 0:没有

for (auto item : pos) {          // 按名字顺序
    std::cout << item.first << ": "
              << item.second << '\n';
}
注意:pos[不存在的键] 会自动插入 。只想判断有没有,用 count。
容器 适合 本讲义里 vector按下标访问 邻接表、dist stack后进先出 撤销、DFS queue先进先出 排队、BFS priority_queue每次取最大/最小 Dijkstra、A* map按键查值 按名字查位置 set不重复 去过的地方
选容器先问:数据怎样访问?在哪里增删? 这就是数据结构要回答的问题。
unordered_map / unordered_set:不保持顺序,通常更快,提一句。
回顾:小车走过的路
阶段 小车能做什么 概念 Linux 有了车库,在目录间来回走 路径、文件操作、重定向与管道 C++ 与构建 在直线上走;拆文件,用外部库 变量、条件、循环、函数、类、多态、CMake 存下来、算得快 记住地图,排名次,查区间耗电 数组、复杂度、排序、二分、前缀和 图与搜索 能否到达,最少几步 图、栈、队列、DFS、BFS、树 最短路 避开泥地,朝终点高效找路 递推、Dijkstra、A*
程序 = 数据结构 + 算法? 同一个框架,换一种 todo 容器,就换了一种算法 。